인공지능(AI, artificial intelligence) 칩이 필요한 세 가지 작업을 가정해 봅시다. 작은 로컬(엣지) 기기에서 음성 모델을 실행하는 일, 책상 위에서 언어 모델을 파인튜닝(fine-tuning, 학습된 모델을 새 데이터로 조정하는 일)하는 일, 데이터센터에서 학습(training, 데이터로 모델을 가르치는 일)과 추론(inference, 학습된 모델로 요청에 답하는 일)을 함께 하는 일입니다. 가정한 세 작업의 AI 워크로드는 서로 다릅니다.
다섯 가지 이름이 논의를 지배합니다. CPU(central processing unit, 범용 프로세서), GPU(graphics processing unit, 그래픽과 병렬 연산을 위한 프로세서), NPU(neural processing unit, 신경망 연산을 위한 프로세서 또는 블록), LPU(language processing unit, Groq와 연결된 추론 아키텍처), TPU(tensor processing unit, Google의 가속기 제품군. 텐서는 다차원 숫자 배열)입니다. 워크로드에서 출발한 뒤 그 주변의 시스템을 그려 보세요.
세 가지 핵심
- 이름들은 서로 겹칩니다. CPU, GPU, NPU는 폭넓은 프로세서 기능을 가리키고, LPU와 TPU는 특정 업체의 아키텍처와 연결된 이름입니다.
- 이름보다 소프트웨어 지원, 메모리, 데이터 이동이 적합성을 좌우합니다.
- 칩 설계, 제조, 패키징, 테스트, 시스템 통합은 서로 다른 책임입니다.
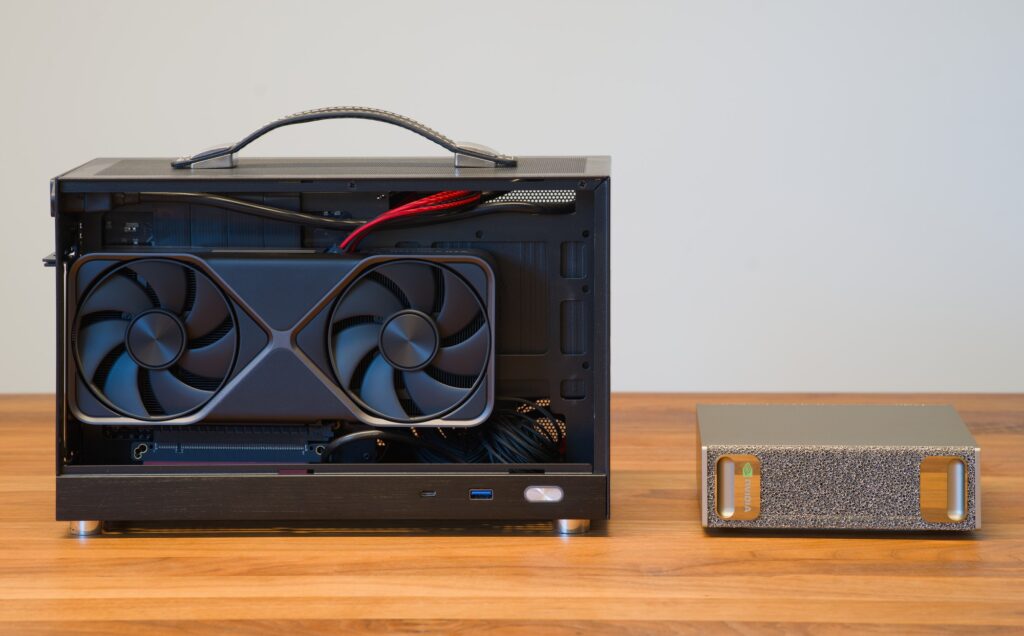
대표 사진: GeForce RTX 5070이 장착된 소형 데스크톱 컴퓨터와 NVIDIA DGX Spark, Daniel Lu (dllu), 2026년 5월 16일 촬영, Wikimedia Commons, CC BY-SA 4.0(Creative Commons Attribution-ShareAlike. 다시 쓰려면 출처를 밝혀야 하고, 변형물은 같거나 호환되는 라이선스로 공유해야 합니다. 이 라이선스는 사진에만 적용되며 아래의 글 재사용 안내와는 별개입니다). 이미지 크기 조정.
모델, 소프트웨어, 운영 조건에서 시작하세요
로컬 기기의 음성 비서는 지연 시간(latency, 답이 도착하기까지의 시간이며 첫 출력까지 또는 전체 응답 완료까지로 잴 수 있음)이 중요합니다. 공유 서빙 클러스터는 처리량(throughput, 초당 끝낸 전체 작업량)과 동시성(concurrency, 동시에 처리 중인 요청 수)이 중요합니다. 언어 모델에서 토큰(token)은 작은 텍스트 조각, 컨텍스트(context)는 모델이 한 번에 보는 토큰 수, 배치(batch)는 함께 처리하는 요청 묶음입니다.
연산자(operator)는 모델 안의 기본 계산 단위이고, 컴파일러(compiler)는 모델을 프로세서용 명령으로 번역하는 소프트웨어이며, 런타임(runtime)은 모델을 실행하는 소프트웨어입니다. 장치를 비교하기 전에 모델, 런타임, 연산자 지원, 품질 목표, 배치, 컨텍스트, 동시성, 데이터 이동, 그리고 필요한 지연 시간 또는 처리량을 맞추세요.
다섯 가지 프로세서 이름과 역할이 겹치는 지점
| 이름 | 가리키는 것 | 문서화된 예 | 먼저 확인할 것 |
|---|---|---|---|
| CPU | 범용 프로세서 | Google의 가이드는 유연한 프로토타이핑과 작은 모델·배치에 CPU를 듭니다 | 이 CPU에서 런타임이 모델을 내 배치 크기로 지원합니까? CPU도 학습과 추론을 수행합니다. |
| GPU | 그래픽과 그 밖의 병렬 연산을 위한 프로세서. NVIDIA의 CUDA(Compute Unified Device Architecture, NVIDIA의 GPU 프로그래밍 플랫폼)에서는 CPU 호스트가 제어하는 장치 | CUDA 가이드는 호스트-장치 구조를 설명합니다 | 프레임워크(framework, 모델을 만드는 소프트웨어 라이브러리)와 CUDA 버전이 학습 또는 추론에 쓰는 모델의 연산자를 지원합니까? CPU와 GPU 메모리 사이에 데이터가 얼마나 복사됩니까? |
| NPU | 신경망 연산을 위한 프로세서 또는 블록 | Arm은 Ethos-U85를 엣지 NPU IP(intellectual property, 재사용 가능한 회로 설계)로 소개하며, 언어·비전 모델에 널리 쓰이는 신경망 설계인 트랜스포머(transformer) 모델을 지원한다고 밝힙니다 | 컴파일러가 모든 연산자를 받아들입니까? 무엇이 CPU로 넘어갑니까(폴백)? |
| LPU | Groq와 연결된 추론 아키텍처 | Groq의 2025년 3월 글은 컴파일러가 연산과 데이터 이동을 미리 스케줄링하고 온칩 SRAM(static random-access memory, 칩 안의 빠른 메모리)을 쓴다고 설명합니다 | 내 모델은 어느 세대와 컴파일러를 대상으로 합니까? |
| TPU | Google의 가속기 제품군 | TPU7x 문서는 JAX와 PyTorch 프레임워크로 학습과 추론을 지원하며 TensorFlow는 지원하지 않는다고 밝힙니다 | 프레임워크가 지원됩니까? 모델이 맞습니까? |
최대 연산 성능보다 컴파일러와 연산자 지원을 먼저 확인하세요
Arm의 Vela 컴파일러는 양자화(quantized, 저정밀 정수로 줄인) 모델을 TensorFlow Lite(TFLite, 엣지용 소형 모델 형식) 또는 TOSA(Tensor Operator Set Architecture, 텐서에 대한 기본 연산의 표준 집합) 형식으로 받아 Ethos NPU용 명령을 만듭니다. TFLite에서는 NPU가 실행할 수 없는 연산자가 CPU에 남고, 문서에 따르면 TOSA 컴파일에는 CPU 폴백이 없습니다. 어떤 연산자가 폴백되는지 목록으로 만드세요. 그 작업은 다른 프로세서에서 실행되므로 둘 사이로 데이터가 이동해야 합니다.
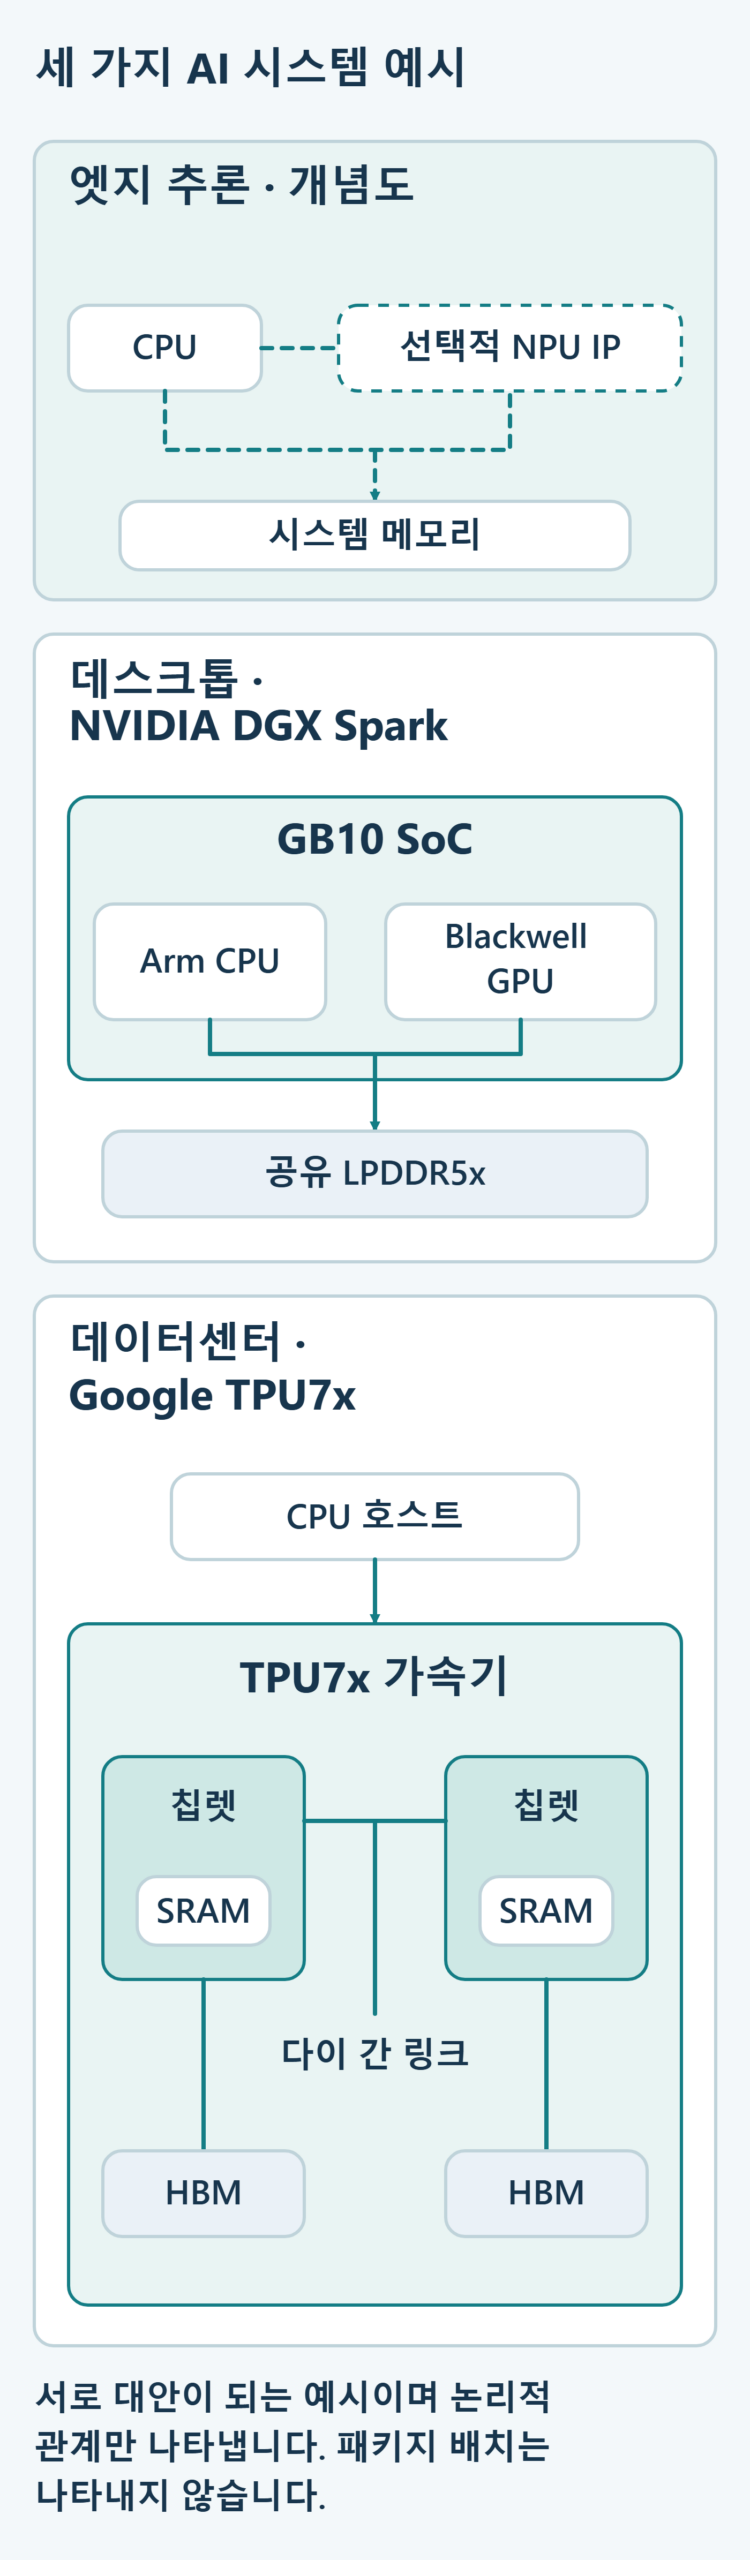
세 가지 시스템 예시로 보는 경계
SoC(system on chip)는 프로세서와 다른 기능을 하나의 칩 설계에 담은 것입니다. 다이(die)는 칩을 만드는 얇은 원판인 웨이퍼(wafer)에서 잘라 낸 실리콘 조각 하나이고, 칩렛(chiplet)은 다른 다이와 함께 동작하도록 설계된 다이이며, 패키지(package)는 다이를 보드에 연결하는 구조입니다.
- 엣지 추론: Arm의 Corstone-320 참조 서브시스템(reference subsystem, 업체가 고객이 가져다 고쳐 쓰도록 제공하는 예시 설계)은 Cortex-M85 CPU와 Ethos-U85를 통합합니다. 라이선스된 블록이나 참조 서브시스템은 고객의 완성된 SoC, 다이, 패키지가 아닙니다.
- 데스크톱 프로토타이핑: NVIDIA DGX Spark의 GB10 SoC는 Arm CPU와 Blackwell GPU를 통합하며, 둘은 LPDDR5x(low-power double data rate 5x, 저전력 메모리 표준)를 공유합니다. 공유는 CPU와 GPU의 중복 복사본을 일부 피하게 하지만, 릴리스 노트가 디스플레이 예약 메모리(display-reserved memory, 화면 출력용으로 따로 떼어 둔 메모리)를 문서화하므로 쓸 수 있는 용량은 줄어들고 데이터는 여전히 메모리를 거쳐 이동합니다.
- 데이터센터 학습과 추론: Google의 TPU7x 문서는 칩렛 두 개가 각각 자기 HBM(high-bandwidth memory, 매우 높은 데이터 속도를 위한 적층 메모리 유형) 메모리 공간을 갖고 다이 간(die-to-die) 인터페이스(두 다이를 직접 잇는 연결)로 서로 연결되며, 온칩 SRAM이 빠른 임시 작업 메모리 역할을 한다고 설명합니다. 하나의 예시이며 보편적 구성이 아닙니다.
누가 설계하고, 제조하고, 패키징하고, 테스트하고, 통합하는가
팹리스(fabless)는 회사가 IC(integrated circuit, 하나의 반도체 칩에 전자 회로를 집적한 소자)를 설계하고 웨이퍼 제조는 외부에 맡기는 사업 모델이며, 파운드리(foundry)는 고객의 설계를 제조합니다. TSMC의 2025 연차 보고서가 이를 설명합니다. 프로세서 이름은 기능 또는 업체별 아키텍처를 가리킬 뿐 이 사업 모델을 가리키지 않습니다.
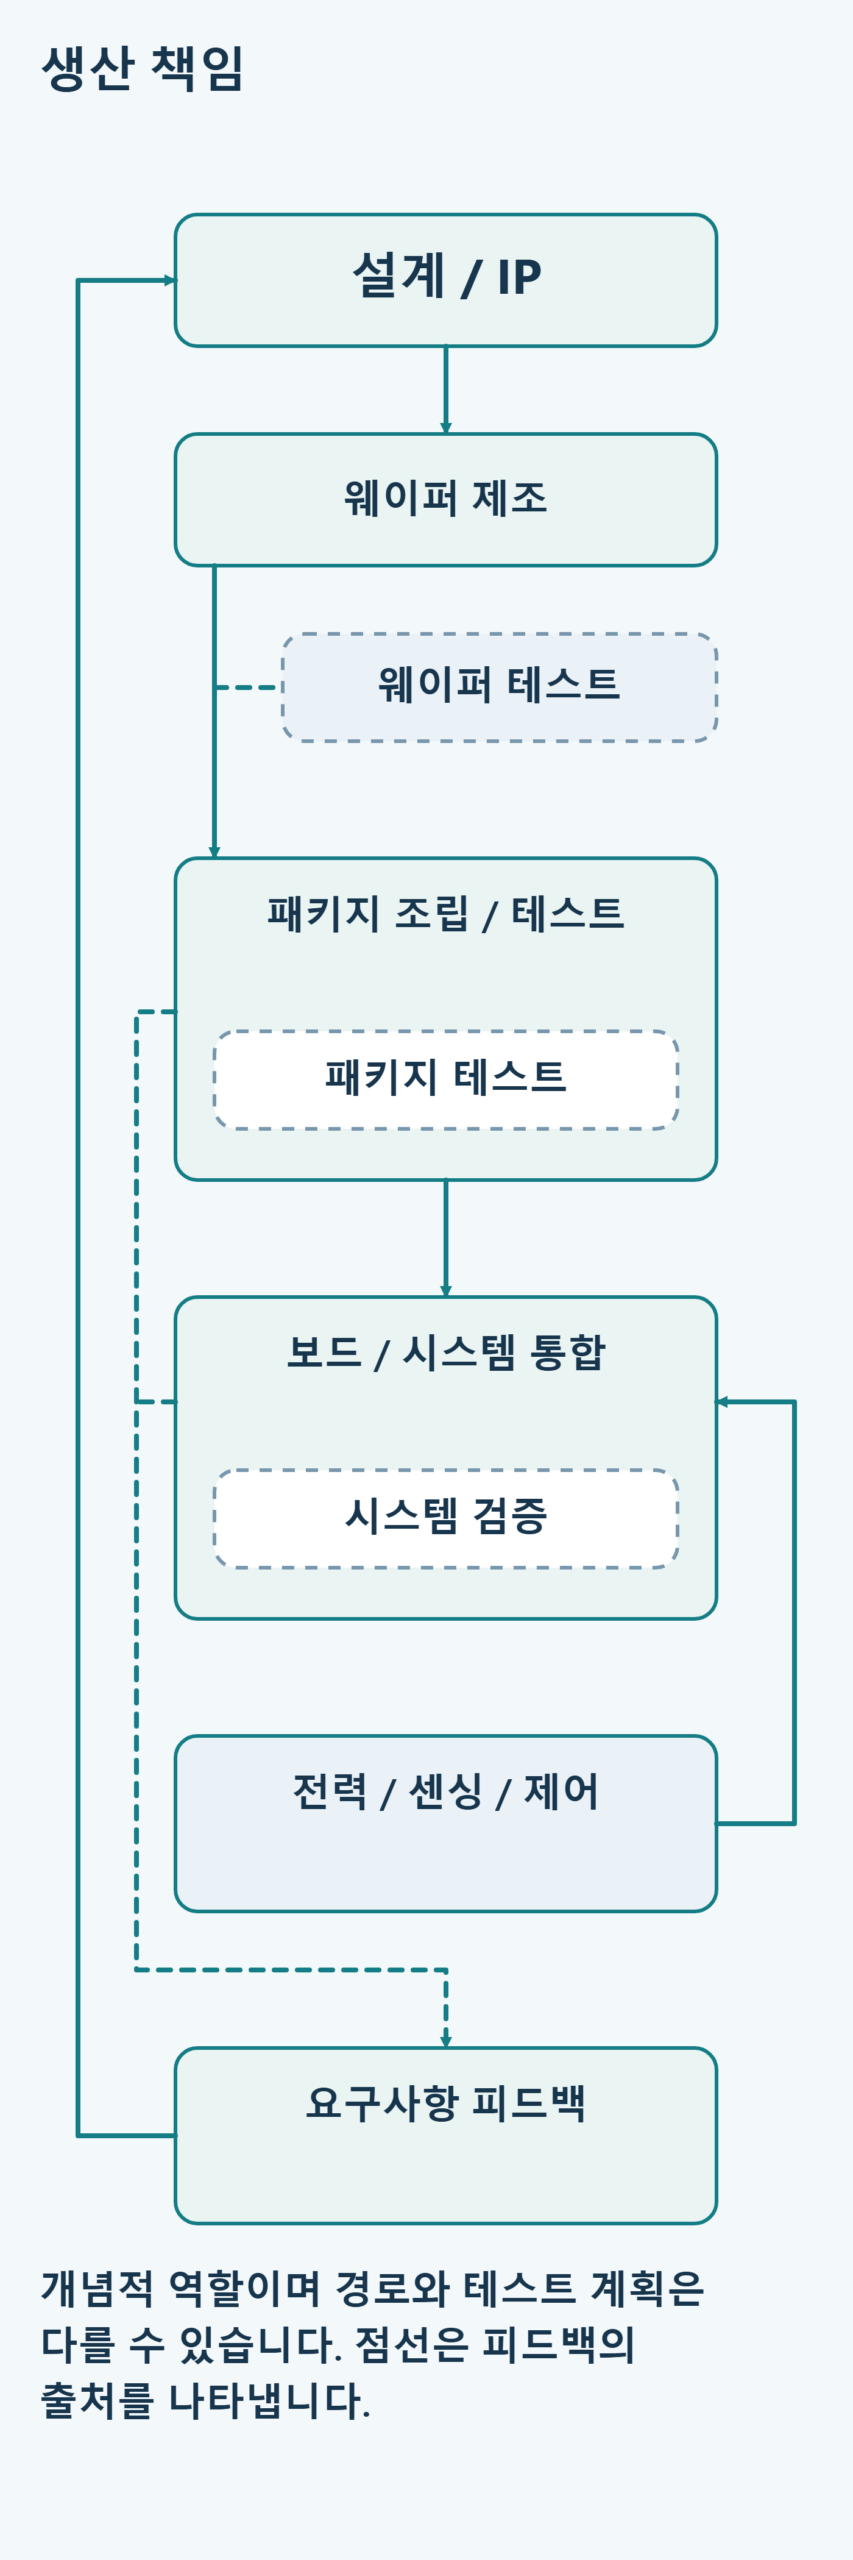
웨이퍼 테스트, 패키지 테스트, 보드·시스템 검증은 서로 다른 체크포인트입니다. 전력 변환(공급 전원을 칩이 필요로 하는 전압으로 바꾸는 일), 센싱(전압·전류·온도를 측정하는 일), 제어는 별도의 요구사항 경로를 이루며, 메모리·패키지·열·테스트 요구사항은 설계로 되돌아갑니다. 칩의 열 설계 전력인 TDP(thermal design power, 업체가 냉각이 감당하도록 설계한 열 수준으로, 측정값이나 최대 소비 전력이 아닌 설계 목표), 전원 공급 장치의 정격, 실측 시스템 소비 전력은 서로 다른 양입니다.
중국의 패키징·테스트 사례와 어디서나 쓸 수 있는 점검표
중국 기반 기업인 JCET Group은 패키징과 테스트 역할을 보여 주는 사례입니다. JCET 웹사이트(날짜 미표기, 2026년 10월 14일 확인)는 웨이퍼 범핑(wafer bumping, 연결 접점 형성), 웨이퍼 프로빙(wafer probing, 웨이퍼를 자르기 전 전기적 테스트), 멀티 다이 조립, 최종 테스트를 포함한 턴키(turnkey) 서비스, 즉 여러 단계를 한 업체가 일괄 처리하는 서비스를 설명합니다. 2026년 8월 20일 상반기(first half, H1) 공시는 서로 다른 다이를 하나의 패키지로 결합하는 AI 관련 이종 집적(heterogeneous integration)을 설명합니다. 이는 회사의 역할에 대해 JCET 자신이 밝힌 설명이며, 특정 가속기에 대한 적격성 검증, 고객 관계, 생산 능력을 확인해 주지는 않습니다.
이 점검표는 일반적으로 적용되며 중국에만 해당하지 않습니다. 공급업체나 설계에 대한 주장마다 다음을 물으세요.
- 근거가 다루는 단계는 웨이퍼, 패키지, 보드, 시스템 중 무엇입니까?
- 누가 언제 밝혔으며, 업체의 설명입니까 측정값입니까?
- 어떤 메모리, 패키지, 열, 테스트 한계가 설계로 되돌아갑니까?
- 정확한 패키지 유형과 테스트 단계에 대한 공급업체 자체 문서는 어디에 있으며, 날짜는 언제입니까?
동일 조건 워크로드 비교를 위한 다섯 가지 질문
- 어떤 모델, 프레임워크, 런타임 버전을 실행해야 하며, 각 프로세서 경로가 모든 연산자를 지원합니까?
- 실제 사용 사례에 필요한 배치 크기, 컨텍스트 길이, 동시성은 얼마입니까?
- 프로세서 사이에서 이동하는 데이터는 얼마나 되며 어디에 있습니까: 공유 메모리, 분리된 메모리 공간, 온칩 SRAM, HBM?
- 무엇이 중요합니까: 첫 출력까지의 대기, 전체 응답이 끝날 때까지의 대기, 많은 요청의 처리량 중 어느 것이며, 어떤 품질 목표에서입니까?
- 설계, 파운드리, 패키지와 테스트, 시스템 통합 중 어느 책임이 누구에게 있으며, 각각을 뒷받침하는 날짜가 있는 근거는 무엇입니까?
다음 행동: 각 후보에서 같은 작업과 데이터를 기록된 조건(정밀도, 품질 목표, 배치, 컨텍스트)으로 실행하세요. 컴파일된 모델 파일은 서로 다를 수 있으므로 기록된 동일 조건 결과만 비교하세요.
관련 글
48 V에서 AI 코어까지: 변환 경계가 IC 문제가 되는 지점 및 AI 데이터센터 액체 냉각: 안정적 운용을 뒷받침하는 아날로그 IC.
주요 1차 자료
- Google Cloud, TPU7x 문서, 2026년 10월 9일 개정.
- NVIDIA, CUDA Programming Guide, v13.4.2, 2026년 9월 10일.
- Arm, Ethos-U85 제품 페이지, 날짜 미표기, 2026년 10월 14일 확인.
- Arm, Vela 컴파일러 문서, 날짜 미표기, 2026년 10월 14일 확인.
- Groq, What is a Language Processing Unit?, 2025년 3월 7일.
- NVIDIA, DGX Spark 하드웨어 개요, 2026년 9월 10일.
- JCET Group, 회사 웹사이트, 날짜 미표기, 2026년 10월 14일 확인.
- JCET Group, 2026년 상반기 공시, 2026년 8월 20일.
공유하실 때는 이 글의 링크를 함께 남겨 주세요. 글 전체를 재게시하려면 문의하여 허락을 받아 주세요.